Score prédictif de tenue des promesses de paiement
Un vrai modèle statistique, entraîné sur vos promesses résolues — pas une supposition.
Les prédictions de Debt Collection sont de vrais modèles statistiques entraînés — régression logistique et arbres de décision ajustés sur l'historique propre de votre espace — jamais un grand modèle de langage ni une estimation réglée à la main. Elles répondent à trois vraies questions : une promesse donnée sera-t-elle tenue, une facture donnée sera-t-elle payée dans un délai donné, et — en combinant les deux — quel est le risque de ce débiteur à l'instant présent.
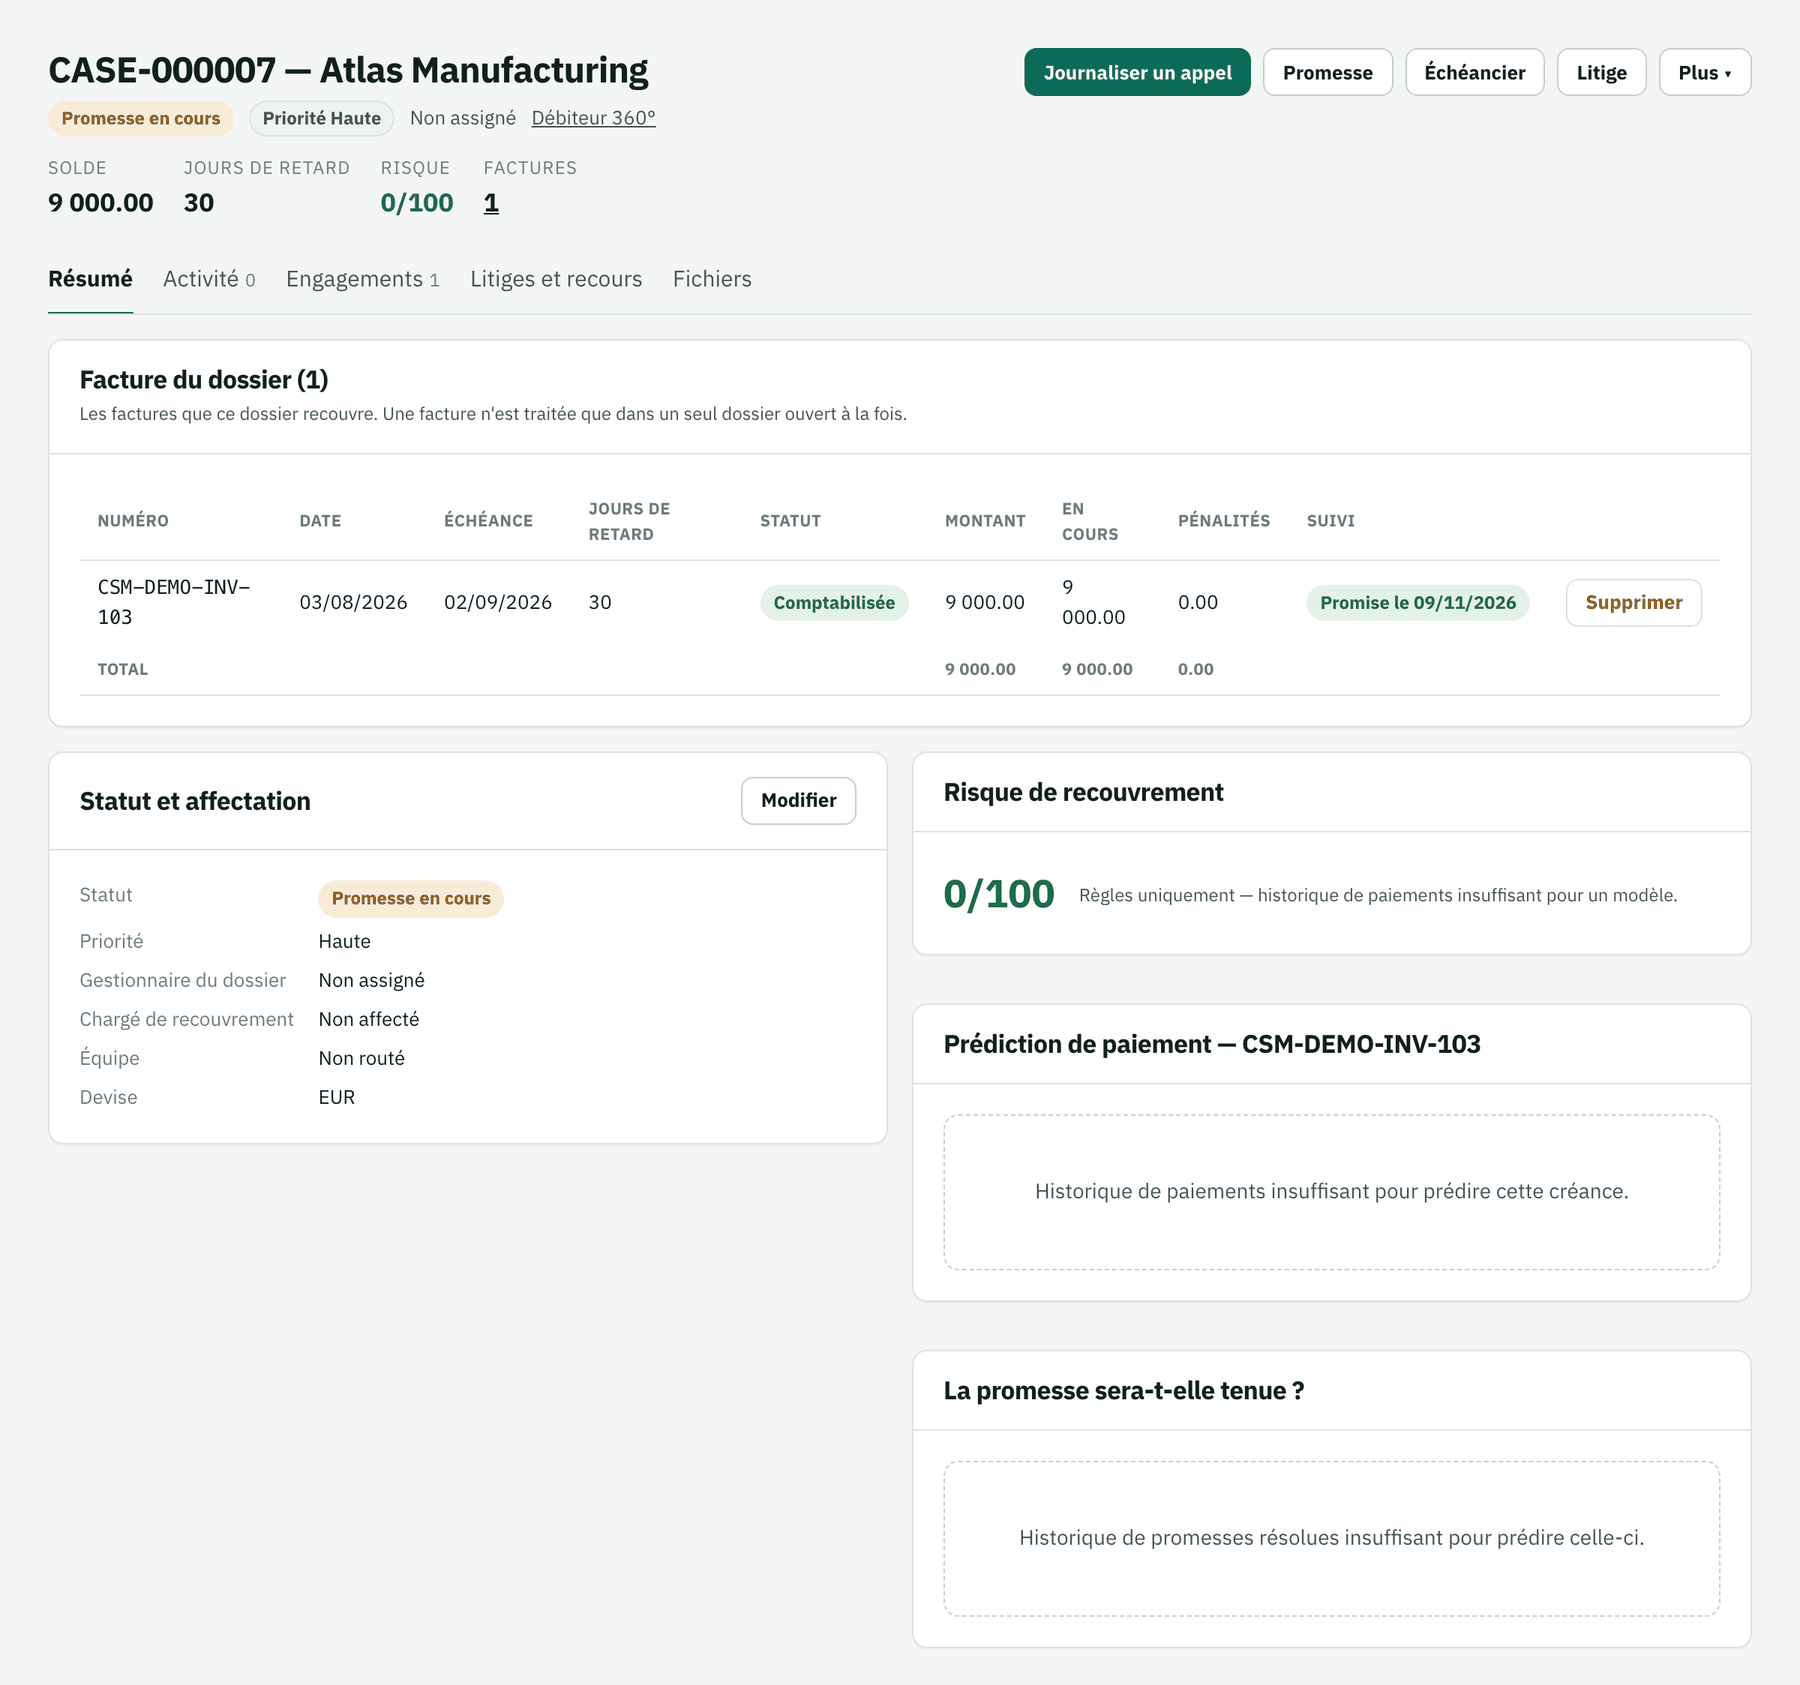
Prédiction de tenue des promesses
Dès qu'un dossier a une promesse de paiement ouverte, sa page affiche la probabilité que cette promesse soit réellement tenue, avec les principaux facteurs qui expliquent ce chiffre en langage clair — montant, jours avant l'échéance, historique de promesses non tenues du débiteur et signaux similaires — pour qu'un manager comprenne pourquoi le score est ce qu'il est, jamais un chiffre nu sans explication.
Prédiction de paiement
La plupart des créances ne font jamais l'objet d'une promesse explicite — le modèle de probabilité de paiement couvre le cas général : pour toute facture ouverte, la probabilité qu'elle soit payée intégralement sous 30 jours (affichée aussi sur la page du dossier, pour sa plus grosse créance ouverte) et, séparément, le montant qu'on s'attend réellement à récupérer dans ce délai. Deux modèles distincts construits sur les mêmes variables : un classifieur pour « va-t-elle être payée » et un arbre de décision en régression pour « combien ».
Score de risque de recouvrement
La page de chaque débiteur affiche un score de risque de 0 à 100 avec une catégorie Faible / Moyen / Élevé / Critique. Il se compose volontairement de deux parties clairement étiquetées, jamais fondues en un chiffre opaque :
- La composante ML — la probabilité de non-paiement prédite par le modèle de probabilité de paiement, pondérée par les montants des créances ouvertes du débiteur.
- La composante règles — des points bornés, nommés et déterministes pour des signaux forts que le modèle ne voit pas encore directement : une promesse non tenue, une créance en retard de plus de 90 jours, une escalade ouverte ou un indicateur de risque élevé existant. Chaque point est listé individuellement dans « Facteurs contribuant à ce score », jamais masqué.
Tant qu'aucun modèle de probabilité de paiement n'a été entraîné (ou si un débiteur n'a aucune créance ouverte à noter), le score de risque se limite à la composante règles — clairement indiqué « règles uniquement » sur la page, jamais présenté avec la même assurance qu'un vrai résultat de modèle.
Quand les données ne suffisent pas encore
Un tout nouvel espace, ou dont les promesses et créances n'ont pas encore été soldées assez souvent, voit un simple message « historique insuffisant » à la place d'un score, sur chacun de ces panneaux. Chaque modèle échoue en sécurité — il n'est jamais entraîné sur trop peu de données juste pour produire un chiffre.
Comment les modèles sont entraînés et contrôlés
Chaque modèle est entraîné par espace, uniquement à partir de l'historique soldé de cet espace — jamais mélangé entre espaces, jamais un modèle partagé ou global. Chaque prédiction réellement affichée à un utilisateur est journalisée avec la version du modèle et l'horodatage qui l'ont produite : une fois le résultat réel connu, la prédiction journalisée lui est comparée et la précision réelle, mesurée, du modèle est suivie dans le temps — distincte (et parfois différente) de sa précision à l'entraînement, ce qui révèle une dégradation du modèle d'un réentraînement à l'autre.
Le réentraînement tourne selon un planning (hebdomadaire) via les tâches de fond de la plateforme, par espace, et ne bloque jamais la requête d'un utilisateur. Un administrateur peut aussi lancer « Réentraîner maintenant » pour n'importe quel modèle depuis Administration → Modèles d'IA, sans attendre le planning.
Isolation des espaces
Chaque espace de ce produit dispose de sa propre base de données physique, et non d'un schéma partagé avec une colonne d'espace. C'est ce qui rend le système d'IA isolé par construction, et non par un filtre supplémentaire qu'on pourrait oublier : un modèle, un journal de prédictions ou un entraînement d'un espace est une ligne dans une base que la connexion d'un autre espace ne touche jamais. Il n'y a ni cache partagé, ni fichier de modèle partagé, ni entraînement inter-espaces nulle part dans cette fonctionnalité.
Au niveau du portefeuille : encaissements attendus
Le chiffre « Encaissements attendus, 30 j » du tableau de bord direction combine les résultats des deux modèles sur tout le portefeuille — les créances adossées à une promesse via le modèle de risque des promesses, toutes les autres via les modèles de probabilité / montant attendu de paiement, additionnés sans compter deux fois la même créance. Il est étiqueté PRÉDICTION sur le tableau de bord, jamais présenté comme un chiffre garanti. Sa consultation ne crée pas de nouvelles lignes dans le journal des prédictions, contrairement à l'ouverture d'une page dossier ou débiteur — une estimation globale de tableau de bord n'est pas une prédiction que quelqu'un a réellement regardée.
Quand aucun des deux modèles n'est encore entraîné, ou que rien n'est dû dans la période, l'indicateur explique pourquoi au lieu d'afficher un chiffre — le même comportement de sécurité que tous les panneaux ci-dessus, jamais un chiffre inventé. Une fois un modèle entraîné, sa précision mesurée s'affiche aussi sous forme de jauge sur le tableau de bord direction : « quelle est la qualité de ce modèle en ce moment » est toujours à un coup d'œil du chiffre qu'il alimente.
Prévision de trésorerie : une méthode distincte et plus simple
Le graphique « Prévision de trésorerie » du tableau de bord direction n'est volontairement pas l'un des modèles ci-dessus — c'est une simple projection moyenne pondérée plus tendance sur les derniers mois de trésorerie réellement récupérée du portefeuille, la même méthode statistique transparente que celle utilisée ailleurs dans le produit pour la prévision du chiffre d'affaires. Sa confiance dépend littéralement du nombre de mois réels et non nuls sur lesquels elle repose — jamais un intervalle inventé. Elle n'apparaît qu'une fois l'historique réel suffisant pour projeter ; un espace tout neuf ne la voit simplement pas encore.
Administration des modèles d'IA
Administration → Modèles d'IA liste chaque modèle que le produit entraîne pour votre espace — statut, algorithme, date du dernier entraînement, nombre de lignes d'entraînement, métriques à l'entraînement et précision réelle mesurée depuis le déploiement — avec l'historique complet des versions et un bouton manuel « Réentraîner maintenant » pour toute personne ayant le droit « gérer les modèles d'IA » (Collection Manager et Administrateur par défaut). Les autres rôles y ont accès en lecture seule.